



AI Run 可能在模型调用前、Provider 执行中或保存结果时失败。应按可见错误判断层级。
额度与限流
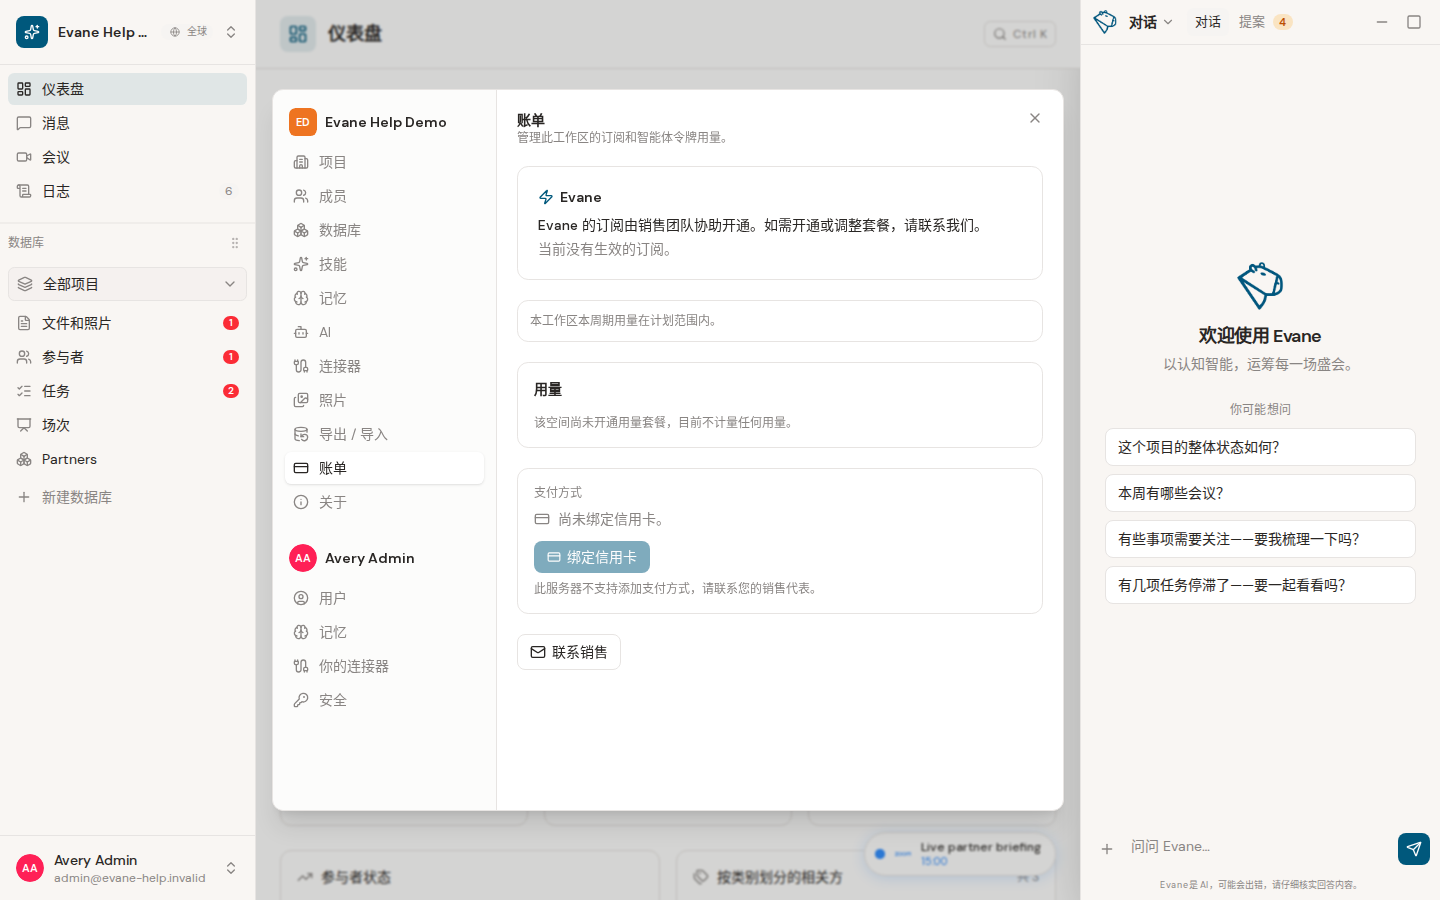
Evane 对空间的并发 Run、每小时 Run 和每月 Token 设置限制,Provider 也可能有独立速率或余额限制。若返回 Retry 时间应等待;清理浏览器数据不会重置服务器额度。
模型可用性
确认所选模型在当前 Provider 和 Deployment 中启用。UI 中合法的模型名不代表当前 Azure/OpenAI/Anthropic 账号或区域一定可用。Admin 应使用 Provider probe 或模型设置检查,不要在聊天中发送凭据。
回复中途停止
与模型的连接断开(代理重置、网关错误)时,系统会先自动重试几次,不会立即让你看到。如果重试仍未成功,Evane 会结束这次 Run,并说明具体原因,而不是留一个空气泡:连接断开、内部错误、对话长度超出模型一次能读取的上限、单次回复达到步骤上限、空间用量已达套餐上限,或所选模型当前不可用。连接断开或内部错误时重新发送消息即可;其余情况需要换一个更短的请求、新开对话,或请管理员处理。
空白或不完整回答
模型可能把输出预算消耗在推理上,仅返回很少可见文本。系统应报告截断,而不是将空内容当作正常结果。可以缩小请求范围,或由 Admin 调整模型感知的 Token 限制。
保留 Run ID、模型、时间、error name 和历史中是否有该 Run。不要提供 API Key 或 Token。

